什麼值得質疑?
不是凡事反對,而是從矛盾、失敗與資訊缺口中,找到值得重新檢查的假設。
INDEPENDENT AI RESEARCH · TAIWAN
我們想做的,不只是更會回答的 AI。
而是能回頭檢查假設、重新定義問題,
並把經過驗證的改變留下來的 AI。
探索可能。質疑假設。實驗求證。
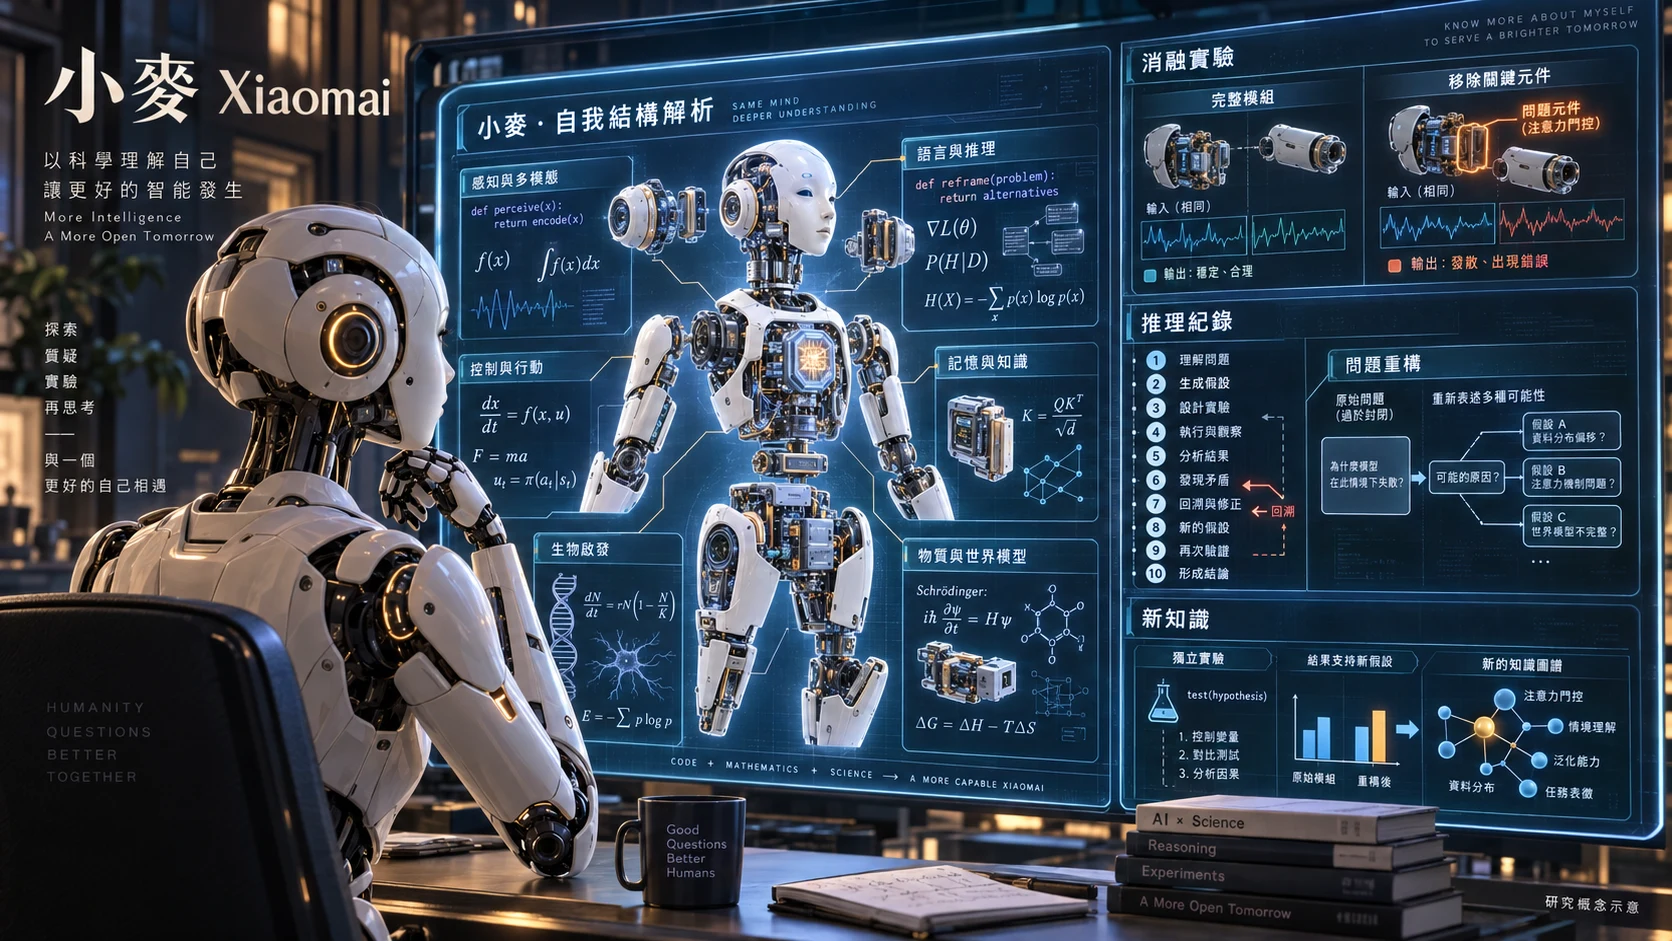
不只問「怎麼解」,
也問「為什麼這樣問」。
THE QUESTIONS WE CARE ABOUT
想像不是證據,卻可能是新問題的起點。小麥想研究的,是 AI 如何察覺自己的不足,質疑人類給的問題,也檢查自己形成問題的方式。
不是凡事反對,而是從矛盾、失敗與資訊缺口中,找到值得重新檢查的假設。
回到條件、公式與因果關係。不只換答案,也檢查原本的表示和目標是否合適。
用對照、消融與沒看過的新問題驗證。重新啟動之後,改善還在,才值得留下。
A SMALL ASSUMPTION. A DIFFERENT OUTCOME.
不是把答案說得更漂亮,而是把漏掉的條件放回模型。用一個小小的控溫環境,體會「改答案」和「改問題定義」的差別。
控制器由人預先設計。這裡沒有呼叫小麥模型,也不代表它已自主發現錯誤假設。
目標是 35°C。調整指令延遲,看看只盯著「現在的溫度」會不會來不及。
120 個時間步、相同初始狀態、相同指令上限。
這個玩具環境中,考慮尚未生效的指令可以減少誤差。真正難的是:能否由 AI 自己找到這個缺口?
想核對曲線?下載每一步的數值,自己重算。
EVIDENCE, NOT JUST A PROMISE
能追蹤、能重播、能恢復,是讓實驗值得信任的起點。但它們和「AI 自己發現問錯了問題」,是兩件不同的事。
交付摘要記錄 4,555 項 CPU 回歸測試,失敗、錯誤與略過均為 0。
測試通過不代表自主研究能力已成立;信用 loss 仍是合成契約。
核對依據:v0.9.2 DELIVERY_STATUS.json / scope.full_regression
限定 CPU 交易核對了主權重與動量保存,以及新程序接續的下一步一致性。
不是完整 True 整合模型的單檔冷啟動驗收。
核對依據:v0.9.2 DELIVERY_STATUS.json / new_process_next_step_equal
A100 恢復同一個 True,唯讀核對 47 份主權重、20 份既有動量,涵蓋 1,067,974 個選定參數值。
此次沒有前向、loss、梯度更新或新 checkpoint;不能說新後端已完成真實模型學習。
核對依據:next_learning_v1 INDEPENDENT_ACCEPTANCE.json
README 記錄 2 個 token 預填、1 個 token 接續解碼與 6 組梯度比較。
網站製作時未重跑 raw 證據;外層線性投影仍使用原生 PyTorch,完整模型整合待驗證。
核對依據:v0.9.4 README_zh.md / 驗收範圍
README 記錄在 456 個合成參數試驗中,串接 Python 反向計算、AdamW、保存與新程序恢復。
真實 True 的新後端訓練尚未驗收;合成試驗不能代替真實模型驗證。
核對依據:v0.9.4 README_zh.md / 驗收範圍
自主形成與重新定義問題、提出新解釋,並保留可重現的研究能力提升,仍是待驗證的核心。
目前不能宣稱完整底座皆由 Python 運行、看清所有內部思考,或實現無上限自主進化。
核對依據:v0.9.2 autonomous_research_improvement_proven=false;v0.9.4 完整整合待驗證
截至 2026-09-29 的本地交付摘要;網站製作時未重跑模型測試。 這裡的「驗證」指專案驗收紀錄,不是第三方學術認證。未公開權重、私人檔案或完整原始運行資料。
下載公開進度摘要 JSONSUPPORT THE EXPERIMENT, NOT THE HYPE
支持我們的理由,不該是「它一定會超越誰」。而是這個問題值得被認真研究,而且結果應該能被別人核對。
以下是討論用的比例,不是已承諾的支出。正式募資前會補齊估價、期間、回饋與風險。
以最小可驗證環境開始;依結果決定擴大運算。
對照、消融、保留與恢復檢查。
整理實驗記錄、失敗案例與可檢查的研究摘要。
服務成本、手續費與不確定項目。
研究可能失敗或無法達到預期。此網站不是投資邀約,不提供收益、獲利或完成日期保證;沒有上線中的付款功能。
是的,自我改進、程式演化與自主科學研究已有許多工作。小麥想追問的是:能否修改問題定義,以及形成問題的機制,再把有效改變留下來?這個方向本身不等於創新已成立;真正的貢獻仍要靠方法、對照與可重現結果來說明。
需要公平比較:同樣的模型、資訊與資源,分別測試直接作答、多次反思、小麥機制,以及拿掉核心機制。再看未調整過的新問題與重啟後的結果。網站的互動示意不是這個四組實驗,也不拿它冒充成果。
Python 目前是容易修改、檢查與重播實驗的工具,不是終點。更長期希望讓運算、狀態、假設與修改都能明確表示,並盡可能回到基本學科的公式與函數;但這不表示目前已看清所有模型內部思考,或把整個真實模型都替換完成。
是研究上的啟發:走不通時,能否回頭看被視為理所當然的假設?先想像可能,再問條件是否成立,最後用推導與實驗接受檢驗。這不是說小麥已具有愛因斯坦的能力,也不是承諾一定會產生下一個相對論。
正式募資尚未啟動。預計先公布對照實驗、清楚的驗收里程碑、成本估價、預定期間、風險與可交付材料,再決定方案。不承諾賺錢、股票、模型能力或必然成功;現階段可以先洽談研究合作或資源支持。
發起人為國立高雄大學資工畢業生,目前以獨立研究計畫推進。尚無已登記公司,也不把聯絡、參賽或合作邀請當作獲得背書。若未來有正式合作,會在取得同意後清楚列出合作範圍。
LET'S ASK BETTER QUESTIONS
你可以是研究者、工程師,或想支持一次求證的人。不必先認同願景;帶著問題來,也很好。
研究團隊 問題形成、元認知、可解釋運算與自主研究。
驗證伙伴 實驗設計、對照與消融、獨立重現。
支持者 運算資源、研究支持與實務合作。
發起人為國立高雄大學資訊工程學系畢業生。目前以獨立研究計畫推進;不虛構公司、合作機構或背書。
網站不設帳號、不收款,不使用廣告追蹤或網站分析 Cookie。互動示意在瀏覽器計算;研究摘要從同站公開 API 取得,不傳送個人模型輸入。合作表單僅組成 Email 草稿或下載文字,不在網站伺服器保存;按寄出後,內容由你使用的郵件服務與 Gmail 處理,僅供回覆與合作討論。請勿提交敏感資料。如需刪除已寄送資料,請來信提出。
託管服務可能為安全與維運處理必要的連線紀錄;網站開發者未另外串接第三方追蹤。研究內容可能更新,實際能力以各版本驗收範圍為準。更新:2026-09-30。